En bref
La catégorie des murs d'images a discrètement cessé de tourner autour des écrans en 2025. Les mouvements produits actuels — l'Infinity EdgeAI de Userful (annoncé avec Microsoft en septembre 2025), la plateforme Cortex de Visiology sur le marché russe, et une liste discrète mais grandissante de projets internes chez Hiperwall, VuWall et Polywall — redéfinissent le mur comme une couche d'inférence qui se trouve piloter des écrans. La question produit n'est plus « combien de sources peut-il afficher », c'est « que remarque réellement le mur pour l'opérateur ». Cet article expose ce que livrent aujourd'hui les murs dotés d'IA, l'architecture qui tourne en dessous, pourquoi l'inférence sur site est le seul chemin qui survit à l'examen de conformité, et où la plupart de ces déploiements échouent réellement en production.
Ce que « doté d'IA » signifie réellement sur un mur
Retirez le vocabulaire marketing et il reste quatre fonctionnalités concrètes que le terme recouvre. Tout le reste est soit l'une de ces quatre sous un autre nom, soit une promesse de feuille de route qui n'a pas été livrée.
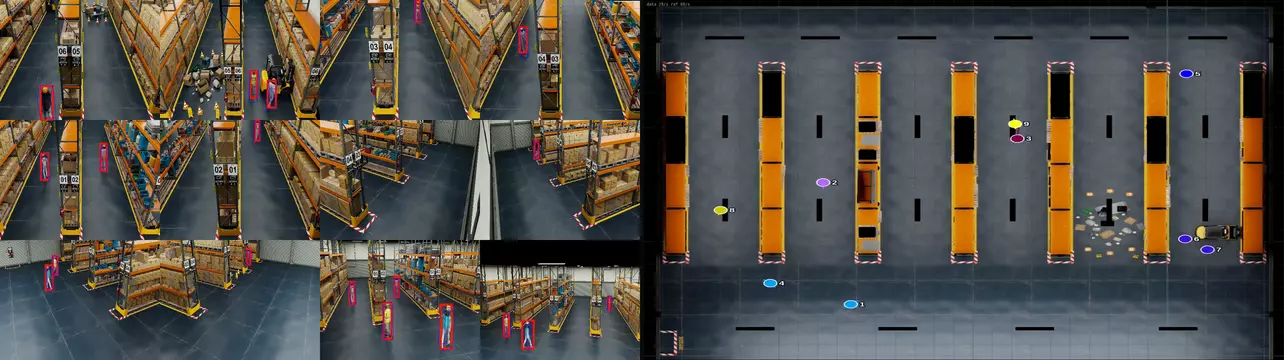
- Détection d'anomalies sur les flux en direct. Un modèle — typiquement quelque chose de la famille YOLO v8 / v9 pour la détection d'objets, ou un détecteur d'anomalies de séries temporelles plus léger pour les sources de tableaux de bord — s'exécute sur chaque flux ingéré et émet un score de confiance. Le contrôleur de mur s'abonne à ces scores et peut réagir lorsqu'ils franchissent un seuil. Courant dans les hubs de transport, la sécurité périmétrique et les tableaux de bord SCADA de l'énergie.
- Promotion de source (bascule de disposition automatique). Lorsqu'une détection se déclenche, la tuile correspondante s'agrandit, se déplace vers une zone centrale du mur et y reste jusqu'à ce qu'un opérateur l'acquitte ou que la détection s'efface. Le moteur de disposition doit prendre en charge à la fois les transitions douces (épinglage / zoom animés) et les coupures franches (réorganisation instantanée) — les opérateurs réagissent différemment à chacune.
- Comptage d'objets et métriques de présence. Comptage de visages pour les salles à forte densité de foule, comptage de véhicules / plaques d'immatriculation pour le trafic, longueur de file pour le commerce. La sortie est généralement un nombre superposé à la tuile source ou poussé vers un tableau de bord voisin rendu par le même mur.
- Corrélation inter-sources. Le palier le plus récent : alimenter plusieurs sources dans un seul pipeline d'inférence et émettre un unique « score de situation » qui pilote la disposition du mur. L'Infinity EdgeAI de Userful en fait la démonstration avec Splunk Enterprise Security + un flux VMS + une source de télémétrie de gestion de bâtiment unifiés dans un seul volet. La maturité reconnaît honnêtement que c'est précoce — la plupart des déploiements réels en restent à la détection d'anomalies mono-source en 2026.
Les références actuelles de la catégorie
Trois produits fixent la barre de la catégorie en 2026, chacun avec un pari différent.
Userful Infinity EdgeAI est le plus visible. Annoncé en septembre 2025 sous forme de préversion co-développée avec Microsoft (Azure IoT Edge pour le déploiement de modèles), avec une disponibilité sur l'Azure Marketplace à partir de 2026, il s'appuie sur le partenariat NVIDIA Inception de Userful. Le positionnement est celui d'une « plateforme de connaissance des opérations » — Userful éloigne délibérément le produit du cadrage « logiciel de mur d'images » pour le placer dans une catégorie à plus forte marge. Les intégrations portent sur Splunk Enterprise Security, Genetec Security Center, Microsoft Sentinel, Everbridge CEM.
La tarification suit le même modèle d'abonnement Enterprise que le reste de Userful — le contrat de la ville d'Austin fixe le prix de la plateforme à 42 $ par écran et par mois (environ 504 $ par écran et par an), plus 13 014 $ de frais de mise en service, hors éventuels frais liés à EdgeAI.
Visiology Cortex est l'homologue russe, construit dans le cadre de la plateforme analytique Visiology plus large. Le pari est différent : plutôt que de s'associer à des hyperscalers, Visiology intègre le stack d'inférence dans la même installation sur site que le reste de la plateforme. Cela correspond à l'environnement de conformité russe (FZ-152, règles d'infrastructure critique FZ-187) mais restreint le menu de modèles — ce qui est livré est ce que Visiology a validé, pas ce que vous pouvez déposer depuis Hugging Face.
Hiperwall, VuWall, Polywall participent à la même conversation mais avec des livraisons actuelles plus restreintes. La version 2026 R1 de Hiperwall a ajouté un « chat opérateur sur site » (un outil de collaboration interne, pas l'inférence elle-même) et une prise en charge GPU Intel élargie. VuWall et Polywall évoquent des intégrations IA via leurs stacks TRx / Polywall compatibles NMOS. Aucun n'a la profondeur que le marketing EdgeAI de Userful revendique actuellement ; savoir si cet écart tiendra jusqu'en 2027 est la vraie question de catégorie.
L'architecture en dessous
Retirez les couches de marque et le stack d'exécution converge vers trois éléments.
- Le modèle. YOLO v8 (Ultralytics) et v9 (développé par des chercheurs de l'Academia Sinica, également intégré au paquet Ultralytics) sont le choix par défaut pour la détection d'objets — ils atteignent un point précision / latence exploitable sur des GPU NVIDIA grand public. Vérifiez la licence : le paquet Ultralytics est sous AGPL-3.0 et le code YOLOv9 original sous GPL-3.0, si bien qu'un produit commercial fermé nécessite normalement une licence Ultralytics Enterprise ou un modèle sous licence permissive. Pour des cas d'usage plus spécialisés — comptage de visages, reconnaissance de plaques, détection d'armes — le modèle adopte des têtes spécialisées mais la structure d'inférence reste similaire.
- L'environnement d'exécution. ONNX Runtime (voir Edge AI pour murs d'images) est la lingua franca : les fournisseurs exportent leur modèle PyTorch / TensorFlow au format ONNX, puis exécutent l'inférence via l'environnement agnostique au framework. Les deux backends qui comptent pour le matériel de mur : NVIDIA TensorRT pour les GPU de classe RTX (≈ 3-5× d'accélération par rapport à ONNX Runtime seul), et Intel OpenVINO pour les GPU intégrés Iris Xe et discrets Arc. Les deux backends acceptent le même fichier ONNX, si bien que le passage du modèle de production de NVIDIA à Intel est une décision au moment du déploiement, pas un réentraînement.
- L'orchestration. Microsoft Azure IoT Edge est le choix par défaut actuel pour « déployer ce conteneur avec ce modèle vers ce contrôleur de mur depuis un point central ». Pour les déploiements sur site sans orchestrateur externe, Kubernetes (k3s sur l'hôte du mur) couvre le même terrain au prix d'un effort de configuration supérieur. Le schéma consiste à conteneuriser chaque modèle et à laisser l'orchestrateur épingler les conteneurs aux GPU disponibles.
Le dimensionnement suit une règle empirique qui tient pour la plupart des déploiements publiés : un seul GPU de classe RTX A4000 absorbe la détection de classe YOLO sur 8 à 12 flux 1080p simultanés tout en laissant tenir à côté la charge de rendu du mur. Une RTX A5000 / A6000 double à peu près ce chiffre. Au-delà de ~20 flux, la charge IA commence à concurrencer le travail GPU du compositeur, et la bonne architecture est un nœud d'inférence séparé aux côtés du contrôleur de mur, qui renvoie les scores via un bus de messages au lieu de tourner sur le même GPU.
L'exigence du sur site n'est pas négociable
Toute acquisition sérieuse d'un mur doté d'IA aboutit à la même ligne rouge : la vidéo en direct ne peut pas quitter le site. Trois cadres réglementaires l'imposent.
- RGPD (UE). Les caméras enregistrant des personnes identifiables produisent des données personnelles au sens de l'article 4(1). Transmettre ces données à un point d'inférence cloud situé dans un pays tiers exige un mécanisme de transfert documenté (pour les fournisseurs américains, le Data Privacy Framework UE–États-Unis ou des clauses contractuelles types), ce dont de nombreux sites préfèrent ne pas dépendre pour de la vidéo en direct. La réponse propre est « l'inférence s'exécute sur site, le cloud ne voit que des métadonnées, le cas échéant ».
- FZ-152 et FZ-187 (Russie). Respectivement les règles de localisation des données personnelles et d'infrastructure critique. Les clients étatiques russes et la plupart des sites d'énergie / de transport doivent exécuter l'inférence dans le pays, souvent sur place. Le pari de Visiology sur une inférence sur site intégrée est conçu spécifiquement pour cette contrainte.
- FedRAMP / DoD IL5+ (fédéral américain). L'IA en cloud pour des données non classifiées contrôlées exige une autorisation FedRAMP détenue par le fournisseur, plus une autorisation DoD IL4 ou IL5 pour les données de défense, tandis que les sites classifiés (IL6) fonctionnent sur des réseaux classifiés distincts, comme SIPRNet. L'inférence sur site, avec des modèles déployés sur le réseau propre du site, est l'attente par défaut.
L'enseignement architectural : la partie IA d'un mur doté d'IA n'est pas une fonctionnalité cloud que l'on greffe avec une clé d'API. C'est un fichier de modèle livré au contrôleur de mur et un environnement d'exécution installé à côté du compositeur. Les fournisseurs qui dissimulent une inférence cloud derrière une démo soignée perdent la vente à l'étape de la conformité.
Où ces déploiements se brisent réellement
Le modèle est rarement le point de défaillance. Trois problèmes opérationnels le sont. Quiconque repositionne un fournisseur en entreprise de murs IA doit avoir une réponse à chacun.
- Les faux positifs érodent la confiance de l'opérateur plus vite que le modèle ne s'améliore. Un mur qui promeut la mauvaise tuile au centre trois fois par quart de travail est ignoré à la quatrième promotion — la vraie. La parade standard est un double seuil : un seuil « afficher un petit indicateur sur la tuile » et un second seuil, plus élevé, pour une perturbation réelle de la disposition. Le produit doit offrir à l'opérateur un moyen clair d'ajuster les deux.
- La dérive du modèle est silencieuse jusqu'à ce qu'elle ne le soit plus. Un compteur de personnes calibré sur des données d'entraînement estivales se met à sous-compter les manteaux d'hiver épais dès novembre. Un détecteur de véhicules calibré sur des plaques européennes se dégrade au Moyen-Orient. Le produit a besoin d'une couche de surveillance — taux de faux positifs dans le temps, nombre de dérogations manuelles — qui donne à l'intégrateur un moyen de repérer la dérive avant le client.
- La piste d'audit des tuiles promues n'est pas négociable pour les acheteurs réglementés. Lorsque le mur a promu la caméra 17 au centre pendant 42 secondes à 14:03:17, quel était le score, quelle version de modèle l'a produit, quel acquittement opérateur a suivi ? La plupart des évaluateurs de conformité veulent pouvoir y répondre. Les fournisseurs qui ont une réponse livrent dans les sites réglementés ; ceux qui n'en ont pas restent dans l'AV d'entreprise.
La place de Craft Wall
Craft Wall exécute l'analyse vidéo sur le GPU du serveur : c'est le même serveur Linux sur site, équipé d'un GPU NVIDIA, qui pilote le mur et traite les flux des caméras.
Les résultats s'affichent sur le mur à côté des caméras et des tableaux de bord auxquels ils se rapportent. La vidéo ne quitte donc jamais le site, et aucun service d'inférence cloud n'intervient.
Le nombre de flux qu'un serveur peut analyser tout en continuant d'assurer le rendu du mur dépend de la résolution des flux, de la fréquence d'images et de la charge d'analyse. Le GPU se dimensionne ainsi projet par projet, au lieu d'être déduit d'un nombre de flux fixe.
Une conclusion honnête
Les murs d'images dotés d'IA ne constituent pas encore une catégorie de produits — ce sont un schéma de déploiement qu'un fournisseur (Userful) articule actuellement le mieux et qu'un second (Visiology) livre le mieux à l'intérieur d'un régime réglementaire unique. La plupart des autres fournisseurs y parviendront en 2026-2027. La question de l'acheteur n'est pas « quel fournisseur de murs IA est le meilleur », c'est « quel cas d'usage justifie réellement l'inférence sur le mur, et notre infrastructure le prend-elle déjà en charge ». La détection d'anomalies sur un périmètre de 12 caméras est un cas qui colle bien. La corrélation inter-sources entre SIEM + VMS + BMS est la démo marketing que la plupart des sites ne feront pas tourner avant deux ans encore.
À lire ensuite : Edge AI pour murs d'images (entrée de glossaire), IPMX vs ST 2110 vs SDVoE pour la question de transport sous-jacente, et la comparaison Craft Wall vs Userful pour voir comment la brique IA s'intègre dans une évaluation concurrentielle.