Kurz gesagt
Die Videowand-Kategorie hörte 2025 leise auf, von Bildschirmen zu handeln. Die aktuellen Produktbewegungen — Userfuls Infinity EdgeAI (im September 2025 mit Microsoft angekündigt), Visiologys Cortex-Plattform im russischen Markt und eine stille, aber beschleunigende Liste hausinterner Projekte von Hiperwall, VuWall und Polywall — rahmen die Wand neu als Inferenzschicht, die zufällig Displays ansteuert. Die Produktfrage lautet nicht mehr „wie viele Quellen kann sie rendern", sondern „was bemerkt die Wand tatsächlich für den Bediener". Dieser Artikel legt dar, was KI-gestützte Wände heute liefern, welche Architektur darunter läuft, warum On-Premise-Inferenz der einzige Weg ist, der die Compliance-Prüfung übersteht, und wo die meisten dieser Bereitstellungen im Produktivbetrieb tatsächlich scheitern.
Was „KI-gestützt" auf einer Wand wirklich bedeutet
Streichen Sie die Marketingsprache, und es bleiben vier konkrete Funktionen, die der Begriff abdeckt. Alles andere ist entweder eine dieser vier mit einem anderen Etikett oder ein Roadmap-Versprechen, das noch nicht ausgeliefert wurde.
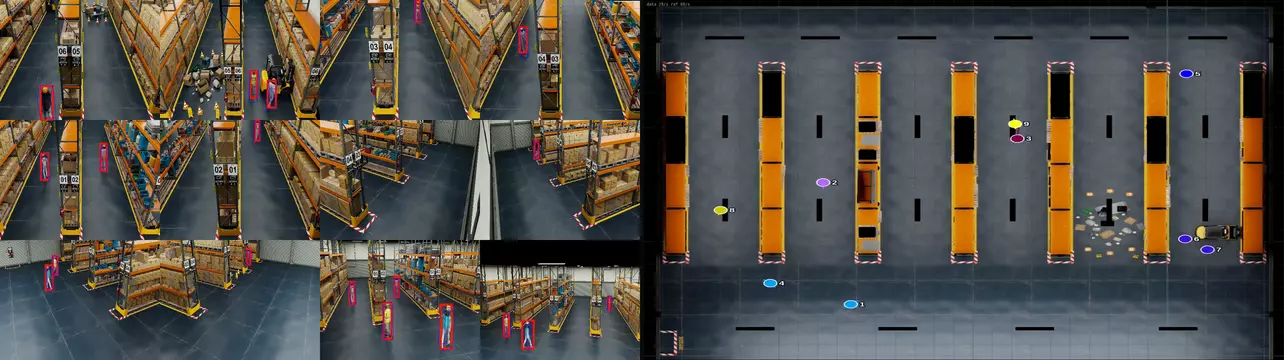
- Anomalieerkennung auf Live-Streams. Ein Modell — typischerweise etwas aus der YOLO-v8-/v9-Familie zur Objekterkennung oder ein kleinerer Zeitreihen-Anomaliedetektor für Dashboard-Quellen — läuft auf jedem aufgenommenen Stream und gibt einen Konfidenzwert aus. Der Wand-Controller abonniert diese Werte und kann reagieren, wenn sie eine Schwelle überschreiten. Verbreitet in Verkehrsknoten, der Perimetersicherung und SCADA-Dashboards der Energiebranche.
- Quellen-Hervorhebung (automatischer Layout-Wechsel). Wenn eine Erkennung auslöst, wächst die zugehörige Kachel, rückt in einen zentralen Bereich der Wand und bleibt dort, bis ein Bediener bestätigt oder die Erkennung erlischt. Die Layout-Engine muss sowohl weiche Übergänge (animiertes Anheften / Zoom) als auch harte Schnitte (sofortige Neuordnung) unterstützen — Bediener reagieren auf beide unterschiedlich.
- Objektzählung und Verweilmetriken. Personenzahl für Räume mit Personendichte, Fahrzeug-/Kennzeichenzählung für den Verkehr, Warteschlangenlänge für den Einzelhandel. Das Ergebnis ist meist eine Zahl, die über die Quellkachel gelegt oder an ein Geschwister-Dashboard derselben Wand geschoben wird.
- Quellenübergreifende Korrelation. Die neueste Stufe: mehrere Quellen in eine einzige Inferenz-Pipeline einspeisen und einen einzigen „Situationswert" ausgeben, der das Wand-Layout steuert. Userfuls Infinity EdgeAI demonstriert dies mit Splunk Enterprise Security + einem VMS-Feed + einer Gebäudemanagement-Telemetriequelle, vereint in einer Ansicht. Die Reife ist ehrlich damit, dass dies früh ist — die meisten realen Bereitstellungen bleiben 2026 bei der Einzelquellen-Anomalieerkennung.
Die aktuellen Kategorie-Benchmarks
Drei Produkte setzen 2026 die Kategorie-Messlatte, jedes mit einer anderen Wette.
Userful Infinity EdgeAI ist das sichtbarste. Im September 2025 als gemeinsam mit Microsoft entwickelte Preview angekündigt (Azure IoT Edge für das Model-Deployment), mit Verfügbarkeit über den Azure Marketplace ab 2026, baut es auf Userfuls NVIDIA-Inception-Partnerschaft auf. Die Positionierung ist „Operations Awareness Platform" — Userful rückt das Produkt bewusst weg vom „Videowand-Software"-Rahmen hin zu einer margenstärkeren Kategorie. Integrationen landen bei Splunk Enterprise Security, Genetec Security Center, Microsoft Sentinel, Everbridge CEM. Die Preisgestaltung folgt demselben Enterprise-Subscription-Modell, das der Rest von Userful nutzt — der Vertrag der City of Austin bepreist die Plattform mit 42 $ pro Display und Monat (rund 504 $ pro Display und Jahr) zuzüglich einer Einrichtungsgebühr von 13.014 $, noch vor etwaigen EdgeAI-Kosten.
Visiology Cortex ist das russische Pendant, gebaut als Teil der breiteren Visiology-Analyseplattform. Die Wette ist eine andere: Statt mit Hyperscalern zu kooperieren, bündelt Visiology den Inferenz-Stack in dieselbe On-Premise-Installation wie den Rest der Plattform. Das passt zum russischen Compliance-Umfeld (FZ-152, FZ-187 für kritische Infrastruktur), schränkt aber das Modellmenü ein — ausgeliefert wird, was Visiology validiert hat, nicht das, was Sie von Hugging Face einklinken können.
Hiperwall, VuWall, Polywall sitzen im selben Gespräch, aber mit engerem aktuellem Lieferumfang. Hiperwalls Release 2026 R1 ergänzte einen „On-Premise Operator Chat" (ein internes Kollaborationswerkzeug, nicht die Inferenz selbst) und breitere Intel-GPU-Unterstützung. VuWall und Polywall verweisen auf KI-Integrationen über ihre NMOS-fähigen TRx-/Polywall-Stacks. Keines davon hat die Tiefe, die Userfuls EdgeAI-Marketing derzeit beansprucht; ob diese Lücke bis 2027 bestehen bleibt, ist die eigentliche Kategorienfrage.
Die Architektur darunter
Streichen Sie die Markenschichten, und der Laufzeit-Stack läuft auf drei Teile zusammen.
- Das Modell. YOLO v8 (Ultralytics) und v9 (von Forschern der Academia Sinica entwickelt, auch im Ultralytics-Paket enthalten) sind die Vorgabe für die Objekterkennung — sie treffen auf Standard-NVIDIA-GPUs einen nutzbaren Punkt aus Genauigkeit und Latenz. Prüfen Sie die Lizenz: Das Ultralytics-Paket steht unter AGPL-3.0 und der ursprüngliche YOLOv9-Code unter GPL-3.0, sodass ein geschlossenes kommerzielles Produkt in der Regel eine Ultralytics-Enterprise-Lizenz oder ein Modell unter permissiver Lizenz benötigt. Für spezialisiertere Anwendungsfälle — Personenzahl, Kennzeichenerkennung, Waffenerkennung — erhält das Modell spezialisierte Köpfe, doch die Inferenzstruktur bleibt ähnlich.
- Die Laufzeit. ONNX Runtime (siehe Edge AI für Videowände) ist die Lingua franca: Hersteller exportieren ihr PyTorch-/ TensorFlow-Modell ins ONNX-Format und führen die Inferenz dann über die Framework-unabhängige Laufzeit aus. Die zwei Backends, die für Wand-Hardware zählen: NVIDIA TensorRT für GPUs der RTX-Klasse (≈ 3-5-fache Beschleunigung gegenüber reinem ONNX Runtime) und Intel OpenVINO für integrierte Iris-Xe- und diskrete Arc-GPUs. Beide Backends akzeptieren dieselbe ONNX-Datei, sodass der Produktionsmodell-Wechsel von NVIDIA zu Intel eine Entscheidung zur Bereitstellungszeit ist, keine des erneuten Trainings.
- Die Orchestrierung. Microsoft Azure IoT Edge ist die aktuelle Vorgabe, um „diesen Container mit diesem Modell von einer zentralen Stelle auf diesen Wand-Controller auszurollen". Für On-Premise-Bereitstellungen ohne externen Orchestrator deckt Kubernetes (k3s auf dem Wand-Host) dasselbe Feld mit mehr Einrichtungsaufwand ab. Das Muster ist, jedes Modell zu containerisieren und den Orchestrator die Container an verfügbare GPUs heften zu lassen.
Die Dimensionierung folgt einer groben Faustregel, die über die meisten veröffentlichten Bereitstellungen hält: Eine einzelne GPU der RTX-A4000-Klasse absorbiert YOLO-Klasse-Erkennung auf 8 bis 12 gleichzeitigen 1080p-Streams, wobei die Rendering-Last der Wand weiterhin danebenpasst. RTX A5000 / A6000 verdoppelt das ungefähr. Oberhalb von ~20 Streams beginnt die KI-Last mit der GPU-Arbeit des Compositors zu konkurrieren, und die richtige Architektur ist ein separater Inferenzknoten neben dem Wand-Controller, der die Werte über einen Message-Bus zurückspeist, statt auf derselben GPU zu laufen.
Die On-Premise-Anforderung ist nicht verhandelbar
Jede ernsthafte Beschaffung für eine Wand mit KI landet bei derselben harten Linie: Das Live-Video darf die Anlage nicht verlassen. Drei regulatorische Rahmen erzwingen das.
- DSGVO (EU). Kameras, die identifizierbare Personen aufzeichnen, erzeugen personenbezogene Daten nach Artikel 4(1). Diese Daten an einen Cloud-Inferenz-Endpunkt in einem Drittland zu senden, erfordert einen dokumentierten Übermittlungsmechanismus (bei US-Anbietern das EU–US Data Privacy Framework oder Standardvertragsklauseln), auf den sich viele Einrichtungen bei Live-Video lieber nicht verlassen. Die saubere Antwort lautet „die Inferenz läuft On-Premise, die Cloud sieht, wenn überhaupt, nur Metadaten".
- FZ-152 und FZ-187 (Russland). Lokalisierung personenbezogener Daten beziehungsweise Regeln für kritische Infrastruktur. Russische Staatskunden und die meisten Energie-/Verkehrsanlagen müssen die Inferenz im Land betreiben, oft vor Ort. Visiologys Wette auf gebündelte On-Premise-Inferenz ist speziell für diese Einschränkung gebaut.
- FedRAMP / DoD IL5+ (US-Bundesbehörden). Cloud-KI für kontrollierte nicht klassifizierte Daten erfordert eine FedRAMP-Autorisierung des Anbieters, bei Verteidigungsdaten zusätzlich eine DoD-Autorisierung für IL4 oder IL5, während klassifizierte Anlagen (IL6) in separaten klassifizierten Netzen wie SIPRNet laufen. On-Premise-Inferenz mit Modellen, die im eigenen Netz der Anlage bereitgestellt werden, ist die Standarderwartung.
Die architektonische Erkenntnis: Der KI-Teil einer KI-gestützten Wand ist keine Cloud-Funktion, die man mit einem API-Schlüssel anschraubt. Es ist eine Modelldatei, die an den Wand-Controller ausgeliefert wird, und eine Laufzeit, die neben dem Compositor sitzt. Hersteller, die Cloud-Inferenz hinter einer glänzenden Demo verbergen, verlieren den Verkauf beim Compliance-Schritt.
Wo diese Bereitstellungen tatsächlich scheitern
Das Modell ist selten der Punkt des Versagens. Drei betriebliche Probleme sind es. Wer einen Hersteller als KI-Wände-Unternehmen neu positioniert, braucht auf jedes eine Antwort.
- Fehlalarme untergraben das Bedienervertrauen schneller, als das Modell sich verbessert. Eine Wand, die dreimal pro Schicht die falsche Kachel in die Mitte befördert, wird bei der vierten Beförderung ignoriert — der echten. Die übliche Gegenmaßnahme sind zwei Schwellen: eine Schwelle „zeige einen kleinen Indikator auf der Kachel" und eine separate, höhere Schwelle für die tatsächliche Layout-Störung. Das Produkt muss dem Bediener einen klaren Weg geben, beide anzupassen.
- Modelldrift ist still, bis sie es nicht mehr ist. Ein Personenzähler, der auf Sommer-Trainingsdaten abgestimmt ist, beginnt im November, dicke Wintermäntel zu unterzählen. Ein Fahrzeugdetektor, der auf europäische Kennzeichen abgestimmt ist, verschlechtert sich im Nahen Osten. Das Produkt braucht eine Überwachungsschicht — Fehlalarmrate über die Zeit, Anzahl manueller Übersteuerungen —, die dem Integrator einen Weg gibt, Drift zu bemerken, bevor der Kunde es tut.
- Ein Audit-Trail für beförderte Kacheln ist für regulierte Käufer nicht verhandelbar. Als die Wand um 14:03:17 Kamera 17 für 42 Sekunden in die Mitte beförderte — welcher Wert war das, welche Modellversion erzeugte ihn, welche Bedienerbestätigung folgte? Die meisten Compliance-Prüfer wollen das beantworten können. Hersteller mit einer Antwort liefern in regulierten Anlagen; die ohne bleiben im Corporate AV.
Wo Craft Wall passt
Craft Wall führt Videoanalysen auf der Server-GPU aus. Derselbe On-Premise-Linux-Server mit NVIDIA-GPU, der die Wand ansteuert, verarbeitet die Kamera-Streams, und die Ergebnisse erscheinen auf der Wand neben den zugehörigen Kameras und Dashboards. So verlässt das Video nie die Anlage, und kein Cloud-Inferenzdienst ist beteiligt.
Wie viele Streams ein Server analysieren kann, während er weiterhin die Wand rendert, hängt von Stream-Auflösung, Bildrate und Analyselast ab. Die GPU wird daher für jedes Projekt dimensioniert, statt aus einer festen Stream-Anzahl abgelesen zu werden.
Das ehrliche Fazit
KI-gestützte Videowände sind noch keine Produktkategorie — sie sind ein Bereitstellungsmuster, das ein Hersteller (Userful) derzeit am besten artikuliert und ein zweiter (Visiology) am besten innerhalb eines einzigen Regulierungsregimes liefert. Die meisten anderen Hersteller werden 2026- 2027 dorthin gelangen. Die Käuferfrage lautet nicht „welcher KI-Wände-Hersteller ist der beste", sondern „welcher Anwendungsfall rechtfertigt tatsächlich Inferenz auf der Wand, und unterstützt unsere Infrastruktur sie bereits". Anomalieerkennung an einem 12-Kamera-Perimeter ist eine saubere Passung. Quellenübergreifende Korrelation über SIEM + VMS + BMS ist die Marketing-Demo, die die meisten Anlagen weitere zwei Jahre nicht betreiben werden.
Weiterlesen: der Glossareintrag Edge AI für Videowände, IPMX vs. ST 2110 vs. SDVoE für die Transportfrage darunter, und der Vergleich Craft Wall vs. Userful dazu, wie der KI-Teil in eine Wettbewerbsbewertung passt.